‘인공지능 허브’ 확대‧클라우드컴퓨팅 지원 등 AI 서비스 개발 돕는다
# 포티투마루는 지난해 개방형 인공지능 허브에서 제공되는 일반상식분야 학습용 데이터를 활용하여 질의응답 소프트웨어(딥시멘틱 QA) 개발 및 상용화에 성공했다. 아마존 챌린지 대회에서 우수상 수상, 기계독해 분야의 글로벌 경진대회(SQUAD2.0)에서 구글과 함께 공동 1위 수상 뿐 아니라, 국제적인 투자유치에도 성공했다.
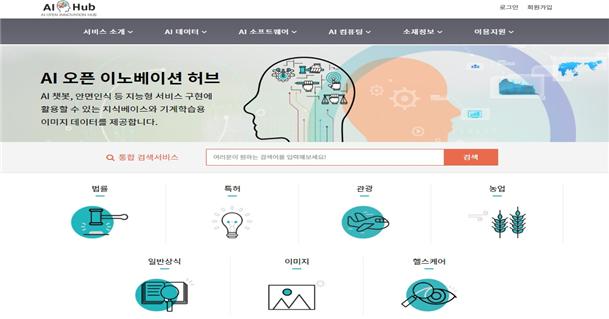
국내 인공지능(AI) 중소‧벤처기업의 경쟁력을 높이기 위한 개방형 AI 개발플랫폼 ‘인공지능 허브’를 확대 구축한다.
‘인공지능 허브’란 누구나 인공지능 기술‧서비스 개발에 필요한 필수 요소를 자유롭게 활용할 수 있는 개발 환경을 제공하기 위해 시작한 사업으로서, 지난해 1월부터 구축‧운영됐다.
정부는 지난 해 8월 국가 차원의 전략적 투자가 필요한 혁신성장 전략투자 분야로 인공지능을 선정, 핵심 사업인 인공지능 허브에 대한 투자를 지난해 92.56억원에서 올해 310억원으로 대폭 확대했다.
지난해까지는 인공지능 개발 필수 요소 중 학습용 데이터 위주로 개방‧제공됐다면, 올해부터는 학습용 데이터 제공을 대폭 확대하는 동시에 개방형 경진대회를 통한 인공지능 알고리즘 개발‧제공과 고성능 컴퓨팅 지원이 보강될 예정이다.
인공지능 학습용 데이터는 인공지능 학습에 활용할 수 있는 형태의 데이터로, 인공지능 기술 및 서비스 개발을 위한 필수 요소이다. 하지만 데이터 구축에 많은 시간과 비용이 소요되어 중소‧벤처기업이 자체적으로 확보하기에는 어려움이 많았다.
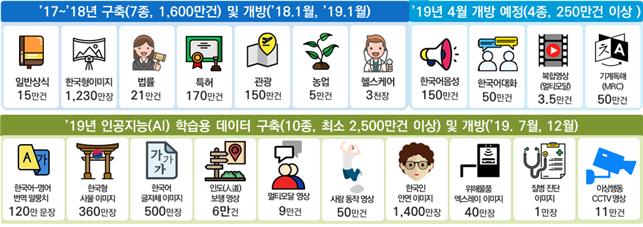
이에 과학기술정보통신부는 2017년부터 인공지능 학습용 데이터 구축을 시작, 지난해 1월부터 일반상식, 이미지, 특허, 법률 등 4종의 학습용 데이터를 제공했다. 금년 1월 중 관광, 농업, 헬스케어 분야 데이터를 추가해 7종으로 확대, 4월에는 한국어 음성‧대화 등 4종을 추가 개방할 예정이다.
금년에는 학습용 데이터의 제공 종류와 규모를 글자체‧동작‧엑스레이 이미지 등 10종(최소 2,500만건)으로 대폭 확대, 개방 시기도 차년도 1월에서 해당연도 7월, 12월로 앞당길 예정이다.
또한 민간 중심으로 인공지능 학습용 데이터가 자생적으로 생성‧확장하는 생태계가 구축될 수 있도록, 대중이 데이터 구축에 참여하는 방식(크라우드 소싱)의 데이터 확산 체계 마련, 학습용 데이터 구축 도구 공개, 인공지능 응용 시범 서비스 등 새로운 서비스도 지속 검토‧도입할 계획이다.
국내 중소‧벤처기업과 연구자 등이 보다 쉽고 효율적으로 인공지능 서비스를 개발할 수 있도록 인공지능 기술 공개를 두 가지 방식으로 확대한다.
첫 번째, 실시간으로 우수 알고리즘을 공개 경쟁하고, 알고리즘 개발 이력과 우수 인재 순위가 공개되는 형태의 온라인 인공지능 경진대회 플랫폼을 새롭게 구축, 운영한다.
올해 첫 회를 맞이하는 온라인 인공지능 경진대회는 누구나 손쉽게 접속하여 자율적인 형태로 기술력을 겨룰 수 있는 혁신의 장으로, 민간 또는 지자체, 다른 정부 부처도 과제를 직접 등록하고 우수 연구자에게 직접 포상할 수 있는 플랫폼으로 활용할 계획이다.
올해에는 도전 문제들을 우수하게 해결하는 20개팀을 발굴(4월경 공고, 7월경 선발)하고, 이후 5개월간(7~11월) 인공지능 서비스 개발‧상용화를 위한 사업화비(평균 1.6억원, 총 32억원)를 지원할 예정이다.
둘째로, 과기정통부가 국책 연구과제로 지원한 기술을 연구자들이 이용하기 쉬운 형태인 오픈 API로 개방하는 범위를 점차 확대한다. API(Application Programming Interface)란 특정 프로그램을 레고 블럭처럼 재조합하여 활용할 수 있도록 제공하는 프로그래밍 인터페이스다.
지난해부터 한국어 질문 분석, 음성처리 등 14종을 개방, 금년 1월 중 대화처리 등 9종을 추가 개방하고 내년 1월에는 질의응답후보추론, 발음평가 등 5종을 추가 개방할 예정이다.
자체 컴퓨팅 환경이 열악한 인공지능 중소‧벤처기업 등을 대상으로 클라우드 기반의 컴퓨팅 자원 지원도 대폭 확대한다. 특히, 딥러닝에 특화된 컴퓨팅 자원 ‘GPU’를 제공, 신속한 인공지능 기술 및 서비스 개발을 촉진할 계획이다. GPU(Graphic Processor Unit)는 수천 개의 소형 코어로 구성되어 딥러닝과 같은 분야에 방대한 데이터를 효율적으로 병렬처리가 가능하다.
올해에는 중소‧벤처기업, 연구‧공공기관, 대학 등의 신청을 받아 200여개 기관을 선정(3월 예정)하고 이후 9개월간(4~12월) 컴퓨팅 자원을 지원할 예정이다.
장석영 과기정통부 정보통신정책실장은 “국내 인공지능 산업의 경쟁력을 키우기 위해서는 국내 개발자들이 인공지능 서비스와 제품을 제약 없이 개발할 수 있는 환경 조성이 중요하다”며 “앞으로도 기술력 있는 국내 중소·벤처기업이 역량을 확보해 세계로 진출할 수 있도록 생태계 마련에 힘쓰겠다”고 밝혔다.
과기정통부는 인공지능 학습용 데이터 구축, 클라우드 컴퓨팅 제공, 경진대회 등 사업 수행에 필요한 사항에 대해서도 사업자 공모 등을 진행할 예정으로, 사업의 신청·접수기간 등 세부적인 내용과 절차, 일정 등 자세한 내용은 1월 22일 AI허브(aihub.or.kr) 또는 한국정보화진흥원 누리집(www.nia.or.kr), 정보통신산업진흥원 누리집(www.nipa.kr)를 통해 확인할 수 있다.
*2019년도 구축 지원 및 개방(안)
| 분야 | 구 축 내 용 | 활용서비스
(예시) |
| 번역
말뭉치 |
o 한국어 인공지능 번역 기술개발 및 성능강화를 위한 한국어-영어 병렬 말뭉치 데이터 120만 문장 구축 | 한국어-영어 AI번역시스템 등 |
| 사물
이미지 |
o 한국형 객체, 장소, 상황 인지기술 개발 및 성능강화를 위한 사물/거리/간판/심볼 이미지 데이터 360만장 구축 | 국내 사물인식 및 안내 서비스 등 |
| 글자체
이미지 |
o 한글 광학글자인식(OCR) 성능개선을 위한 한글 글자체(손글씨 및 인쇄체) 이미지 500만장 구축 | 자동 한글 인식 서비스 등 |
| 인도보행
영상 |
o 시각장애인, 전동휠체어 등의 보행지원기술 개발을 위한 국내 인도‧횡단보도 보행 영상 및 인도위 객체(사람, 자전거, 가로수, 펜스 등) 라벨링 데이터 6만건(500시간) 구축 | 장애인 길안내, 자율전동 휠체어 등 |
| 복합영상 | o 감성인식 AI개발을 위해 동영상에서 인물의 표정, 음성, 발화 내용, 상황 등의 감정이 포함된 다중영상 데이터 9만건(50시간) 구축 | 인간의 감정, 상황 이해 로봇 등 |
| 사람동작
영상 |
o 사람의 동작‧자세‧행동 인식기술 개발을 위해 다양한 조건에서 사람 동작 영상 데이터 50만건 구축 | 가정, 공공시설 등의 서비스 로봇 등 |
| 안면
이미지 |
o 다양한 각도, 조도 등의 환경 하에서 안면인식‧식별 성능강화를 위한 한국인 얼굴 이미지 데이터 1,400만장 구축 | 한국인 얼굴 인식 AI시스템, 범죄자 탐지 |
| 위험물
이미지 |
o 위험물‧도구 자동판별 기술개발 및 성능개선을 위한 위험물, 범죄 도구, 반입금지물품 등의 X-ray 이미지 40만장 구축 | 공항,항만,철도,주요 시설 AI보안 검사 |
| 질병진단
이미지 |
o 국내에서 유병률, 중증도 등이 높은 주요 질환관련 진단 이미지(X-ray, MRI, 초음파 영상 등) 및 진단결과 데이터 1만장 구축 | 주요질병 자동검진 AI의사 |
| 이상행동
영상 |
o 이상행동 지능형 탐지기술 성능 강화를 위한 주‧야간 적용가능한 이기종(가시광선, 적외선) 영상 데이터 11만건(300시간) 구축 | 지능형 CCTV, AI안전감시 |


편집장/ Editor-in-Chief
국가 안보 정책과 연계된 과학기술 분야 혁신 등 영향력 있는 분석을 생산하고 있다. 주로 핵심 과학기술 연구, 글로벌 안보, 지정학, 해양 전략을 주제로 집필한다.
Contact: navy@scimonitors.com / LinkedIn