챗GPT 동일 기술로 과학 위한 AI 구축 시작
영국 캠브리지 대학(university of Cambridge)을 포함한 국제 과학자 팀은 ChatGPT와 동일한 기술을 활용하여 과학적 발견을 위한 AI 기반 도구를 구축하는 새로운 연구 협력을 시작했다.
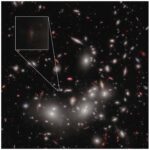
ChatGPT가 단어와 문장을 다루는 동안 팀의 AI는 과학 분야 전반의 수치 데이터와 물리 시뮬레이션을 통해 학습하여 과학자들이 초거성부터 지구 기후까지 모든 것을 모델링하는 데 도움을 준다.
팀은 이번 주 초 arXiv에 일련의 관련 논문을 게시하는 것과 함께 Polymathic AI라는 이니셔티브를 시작했다.
“이것은 사람들이 과학에서 AI와 기계 학습을 사용하는 방식을 완전히 바꿀 것”이라고 뉴욕시에 있는 Flatiron Institute 전산 천체 물리학 센터 그룹 리더 Polymathic AI 수석 연구원인 Shirley Ho는 말했다.
Ho는 Polymathic AI의 기본 아이디어는 “이미 5개 언어를 알고 있을 때 새로운 언어를 배우는 것이 더 쉬운 것과 유사하다”라고 말했다.
기초 모델이라고 하는 미리 훈련된 대규모 모델로 시작하는 것이 과학 모델을 처음부터 구축하는 것보다 더 빠르고 정확할 수 있다. 훈련 데이터가 당면한 문제와 명백하게 관련되지 않더라도 이는 사실일 수 있습니다.
“필요한 컴퓨팅 성능의 규모로 인해 본격적인 기초 모델에 대한 학문적 연구를 수행하는 것은 어려웠다”라고 케임브리지 응용수학과 이론물리학과 및 천문학 연구소의 공동 연구자인 마일스 크랜머(Miles Cranmer)는 말했다.
이들은 Simons Foundation과의 협력해 프로토타입 구축을 시작했다.
Polymathic AI 팀에는 Simons Foundation과 Flatiron Institute, New York University, Cambridge University, Princeton University 및 Lawrence Berkeley National Laboratory의 연구원이 포함됐다. 팀에는 물리학, 천체물리학, 수학, 인공지능, 신경과학 분야의 전문가가 참여했다.
과학자들은 이전에 AI 도구를 사용해 본 적이 있지만 주로 관련 데이터를 사용하여 목적에 맞게 구축하고 훈련했다.
“최근 몇 년 동안 다양한 과학 분야에서 기계 학습이 급속히 발전했음에도 불구하고 거의 모든 경우에 기계 학습 솔루션은 특정 사용 사례를 위해 개발되었으며 일부 매우 구체적인 데이터에 대해 훈련했다”고 프랑스 국립과학연구소(CNRS) 소속 공동 연구자 Francois Lanusse는 말했다.
그는 “연구에 AI를 사용하는 과학자들은 존재할 수 있는 정보가 아니라 다른 형식 또는 완전히 다른 분야의 정보로부터 이익을 얻는다”고 덧붙였다.
Polymathic AI의 프로젝트는 물리학과 천체 물리학(그리고 최종적으로는 화학과 유전체학과 같은 분야)의 다양한 소스에서 얻은 데이터를 사용하여 학습하고 이러한 다학제적 지식을 광범위한 과학 문제에 적용할 예정이다. 로렌스 버클리 국립 연구소(Lawrence Berkeley National Laboratory)의 박사후 연구원인 마리엘 페티(Mariel Pettee) 프로젝트 멤버는 이 프로젝트가 “외견상 서로 다른 많은 하위 분야를 부분의 합보다 더 큰 무언가로 연결할 것”이라고 말했다.
훈련 데이터는 우주의 기초가 되는 물리학을 포착하는 실제 과학 데이터세트도 사용한다.
투명성과 개방성은 프로젝트의 큰 부분이다. Ho는 “우리는 모든 것을 공개하고 싶다. 우리는 몇 년 안에 광범위한 과학적 분석을 개선하는 데 도움이 될 수 있는 사전 훈련된 모델을 다양한 분야 커뮤니티에 제공할 수 있는 방식으로 과학을 위한 AI를 민주화하고 싶다”고 말했다.
*Michael McCabe et al, Multiple Physics Pretraining for Physical Surrogate Models, arXiv (2023). DOI: 10.48550/arxiv.2310.02994
*Siavash Golkar et al, xVal: A Continuous Number Encoding for Large Language Models, arXiv (2023). DOI: 10.48550/arxiv.2310.02989
*Francois Lanusse et al, AstroCLIP: Cross-Modal Pre-Training for Astronomical Foundation Models, arXiv (2023). DOI: 10.48550/arxiv.2310.03024