[기획3]휴머노이드 데이터 전쟁… 실제 산업 현장이 AI를 키운다
가상 시뮬레이션과 1인칭 영상에서 공장·물류 실전 데이터로
중국 애지봇, 미국 피규어AI·어질리티·구글 ‘현장 데이터’ 작업
사이언스모니터 기획시리즈 | 글로벌 피지컬 AI 패권 경쟁 ③
챗GPT 같은 언어 모델은 세상에 이미 깔린 웹페이지와 책, 코드를 긁어모아 몸집을 불렸다. 하지만 로봇 AI에게는 그 거대한 인터넷 바다가 무용지물에 가깝다. 컵의 손잡이를 어느 각도로 쥐어야 미끄러지지 않는지, 구겨진 셔츠를 어떤 힘으로 펴야 하는지 담긴 데이터는 웹상에 존재하지 않는다. 누군가 현실 세계에서 직접 몸을 움직여 새로 만들어내야만 얻을 수 있는 값비싼 자산이다.
앞선 1부와 2부에서 살펴봤듯 오픈AI는 범용 모델의 추론 능력을 로봇에 심으려 하고, 엔비디아는 시뮬레이션과 파운데이션 모델을 묶어 생태계의 판을 짜고 있다. 그러나 아무리 뛰어난 두뇌와 가상 실험실을 갖춰도 현실의 물리 법칙을 가르칠 데이터가 없으면 로봇은 한 걸음도 떼지 못한다. 지금 글로벌 로봇 업계는 원격조작, 사람의 작업 영상, 가상 시뮬레이션, 그리고 실제 현장 배치라는 네 가지 데이터 파이프라인을 두고 치열한 전쟁을 벌이고 있다.
시뮬레이션이 복제할 수 없는 ‘0.1밀리미터의 변수’
가상 시뮬레이션과 인간의 1인칭 시점(FPV) 작업 영상이 로봇 학습의 속도를 획기적으로 끌어올린 것은 분명한 사실이다. 엔비디아가 사람 영상 2만 시간으로 학습시킨 GR00T 모델의 작업 완료율을 두 배 이상 높였고, 오픈AI의 GPT-6 Astra 역시 시뮬레이션 벤치마크에서 74.8%라는 높은 성공률을 기록했다.
문제는 가상 공간의 물리 법칙이 현실의 복잡성을 백 퍼센트 담아내지 못한다는 데 있다. 실제 공장과 물류센터에서는 물체의 미세한 무게 중심 이동, 바닥의 마찰력 변화, 센서 노이즈, 통신 지연, 주변 작업자의 예측 불가능한 동선이 매초 뒤엉킨다.
피지컬 AI(Physical AI)가 요구하는 진짜 데이터는 단순한 카메라 영상 기록이 아니다. 로봇이 물체를 인식한 시각 정보에 더해 각 관절의 토크 수치, 손끝의 힘과 촉각 센서 반응, 동작이 실패했을 때의 물리적 원인과 인간 작업자가 개입해 이를 바로잡은 궤적까지 한 덩어리로 묶여야 비로소 살아있는 학습 자산이 된다.
| 방법 | 내용 | 장점 | 한계 |
|---|---|---|---|
| 원격조작 | 사람이 로봇을 직접 조종해 동작 기록 | 로봇 관절·힘 정보까지 그대로 남음 | 로봇과 조작자가 모두 필요해 비용이 큼 |
| 사람 1인칭 영상 | 사람이 카메라를 메고 작업하는 영상 | 대량 수집이 쉬움 | 사람 몸과 로봇 몸의 차이를 보정해야 함 |
| 시뮬레이션·합성 | 가상 환경과 월드 모델로 데이터 생성 | 무한히 반복 가능 | 가상과 현실의 차이 |
| 현장 배치 | 실제 작업 중 성공·실패·고장 기록 | 현장 문제를 그대로 반영 | 로봇을 먼저 팔아야 쌓임 |
사람 영상으로 방향 튼 기업들
피규어는 2025년 9월 ‘프로젝트 고빅(Project Go-Big)’을 발표했다. 실제 가정에서 찍은 사람의 1인칭 영상으로 휴머노이드를 사전학습하는 계획이다. 부동산 운용사 브루크필드가 협력사로 참여했다. 브루크필드는 전 세계에 주거용 10만 가구 이상을 보유하고 있다.
피규어는 자사 모델 헬릭스를 사람 영상만으로 학습시켜, “냉장고로 가”와 같은 언어 명령에 따라 어질러진 공간을 이동하도록 했다고 밝혔다. 이 이동 기능 학습에는 로봇 시연 데이터가 쓰이지 않았다는 설명이다. 물체 조작까지 같은 방식으로 학습했다는 발표는 아니다.
테슬라 역시 발 빠르게 방향을 틀었다. 테슬라는 지난해 6월 부터 모션캡처 슈트와 원격조작 중심의 옵티머스 학습을 작업자 영상 중심으로 바꿨다. 작업자는 카메라 5대가 달린 헬멧과 배낭을 메고 물건 집기, 셔츠 개기 등을 반복한다.
엔비디아의 GR00T N1.7도 같은 방향이다. 사람 1인칭 영상 2만 854시간으로 사전학습 한 엔비디아는 사람 영상을 늘릴수록 작업 완료율이 오른다고 밝혔다. 사람 영상은 로봇 대수와 상관없이 늘릴 수 있다는 점에서 원격조작보다 확장이 쉽다.
로봇 데이터는 여전히 필요하다
사람 영상에는 로봇 관절의 각도나 손끝에 걸리는 힘이 담기지 않는다. 그래서 사전학습 뒤에는 각 로봇에 맞춘 추가 학습이 따른다. 중국 애지봇이 2025년 공개한 데이터셋 ‘AgiBot World’는 217개 작업, 100만 건 이상의 로봇 동작 기록을 담았다. 사람이 검수하는 표준 수집 절차를 거쳤다.
미국 스타트업 피지컬 인텔리전스(Physical Intelligence)는 4월 범용 로봇 모델 π0.7을 내놓았다. 회사는 여러 상황에서 배운 기술을 조합해 학습하지 않은 작업을 수행하는 사례를 공개했다. 공동창업자 세르게이 레빌린 UC버클리 교수는 “능력이 데이터 양에 비례하는 것 이상으로 오르고 있다”고 말했다. 다만 비교 대상은 회사의 이전 모델로 제한적이고, 로봇 분야에는 표준 벤치마크가 없어 외부 검증이 어렵다.
중국, 데이터 수집 센터를 인프라로
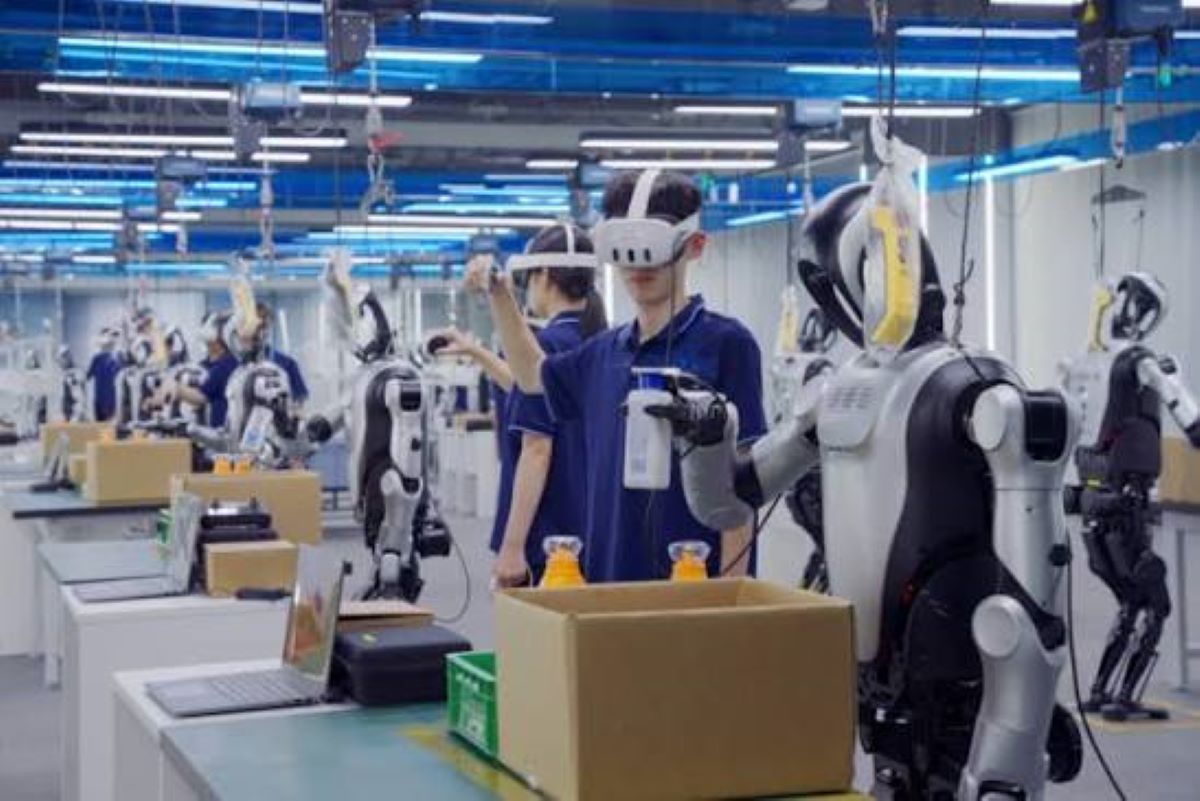
중국은 로봇 훈련 데이터를 만드는 전용 시설을 짓고 있다. 인민일보에 따르면 베이징 스징산구의 훈련 센터는 면적 1만㎡ 이상에 소매점과 물류 거점을 재현했다. 2025년 10월 휴머노이드 100대가 훈련을 시작했고, 로봇 한 대가 하루 약 4시간 분량의 데이터를 만든다.
로봇들은 열쇠로 자물쇠 열기, 옷 개기, 택배 분류, 바코드 스캔 등을 반복한다. 이른바 ‘로봇 유치원’이자 ‘직업학교’로 불리는 이런 훈련 시설은 이제 중국 전역으로 번지고 있다. 2026년 하반기 기준 베이징 국제로봇산업단지와 상하이, 산둥성 칭다오 등 전국 70여 곳에 달하는 훈련장이 가동 중이다. 국가 차원의 직업 기능 훈련센터에서도 가정과 의료, 산업 현장을 아우르는 30여 종의 실제 환경을 구현해 로봇들을 정식으로 훈련하고 있다. 황테지우 베이징인공지능연구원(BAAI) 이사장은 이러한 대규모 훈련 환경 구축이 중국의 제15차 5개년 계획(2026~2030) 강요에 공식 포함됐다고 밝혔다.
미국 기업이 자사 데이터를 각자 모으는 데 비해, 중국은 훈련 시설을 공공 인프라로 운영하는 사례가 많다. 더 자세한 중국의 정책은 7부에서 다룬다.

현장 배치 데이터
현장에서 쌓이는 데이터는 다른 방법으로 대체하기 어렵다. 1부에서 다룬 피규어의 BMW 스파턴버그 공장 운영이 예다. 오픈AI와 결별한 뒤 독자 노선을 걸어온 피규어 AI는 미국 사우스캐롤라이나주 BMW 스파턴버그 공장에 휴머노이드 Figure 02를 투입하며 값진 교훈을 얻었다. 주 5일, 하루 10시간씩 약 11개월 동안 가동된 로봇은 누적 1,250시간 이상 일하며 9만 개가 넘는 부품을 날랐고, BMW X3 차량 3만 대 이상의 생산 공정에 직접 참여했다.
이 과정에서 피규어 AI가 손에 쥔 것은 단순한 작업 기록이 아니었다. 실제 양산 라인의 열악한 환경 속에서 드러난 하드웨어의 고장 지점, 장시간 가동에 따른 발열 문제, 가장 부하가 많이 걸리는 손목 구동계의 기계적 한계를 낱낱이 찾아냈다. 회사는 현장에서 흘린 이 실패 데이터를 고스란히 차세대 모델인 Figure 03의 설계와 자체 AI 모델 Helix의 고도화에 쏟아부었다. 시뮬레이션 화면 속에서는 결코 발견할 수 없었던 물리적 결함을 현실의 땀방울로 메운 셈이다.
물류 현장의 어질리티 로보틱스 역시 같은 길을 걷고 있다. 글로벌 물류기업 GXO와 손잡고 조지아주 플로리브랜치 물류센터에서 이족보행 로봇 Digit를 상업적으로 운영해 온 어질리티는 오는 2027년 초 노스캐롤라이나와 테네시주 시설로 배치를 대폭 확대하기로 했다. 구글 딥마인드 또한 앱트로닉의 휴머노이드 Apollo 2를 메르세데스-벤츠 생산라인에 투입해 자동차 부품을 대량 보관함에서 꺼내 순서대로 분류하는 작업에서 96%라는 높은 성공률을 끌어내며 현장 데이터의 가치를 입증했다.
러스 테드레이크 MIT 교수는 포천에 현장에 배치된 로봇이 그 현장의 데이터를 모으며, 파운데이션 모델이 좋아질수록 이 데이터의 가치가 커진다고 말했다. 테드레이크 교수는 로봇 기업 월든 로보틱스의 CEO다.
일론 머스크 테슬라 CEO는 10월 실적 발표에서 “로봇을 1만~2만 대 규모로 만들어 스스로 훈련(self-play)하게 해야 한다”고 말했다. 로봇을 많이 만들어야 데이터가 쌓이고, 데이터가 쌓여야 로봇이 쓸모 있어지는 순환 구조다. 양산 경쟁은 4부에서 다룬다.
데이터의 양보다 무서운 ‘폐쇄형 데이터 플라이휠’
피지컬 AI 시장의 데이터 전쟁은 양적 경쟁을 넘어섰다. 이제 승패는 현장에서 얻은 데이터를 얼마나 빠르게 AI 모델과 하드웨어 개선으로 되돌려 보내는가, 이른바 ‘데이터 플라이휠’의 회전 속도에 달려 있다.
로봇이 공장에서 작업을 수행하다 실수를 저지르면, 그 실패 데이터는 즉시 클라우드로 전송해 AI 모델의 가중치를 수정하고 심지어 다음 세대 로봇의 관절 설계까지 바꾼다. 업그레이드된 로봇이 다시 현장에 투입되면 작업 성공률과 가동시간이 늘어나고, 그만큼 더 정교하고 희소한 예외 상황 데이터가 쌓이는 선순환이 완성된다.
반도체와 자동차, 전자제품 등 세계 최고 수준의 정밀 제조 공정에서 이 지점은 거대한 기회이자 경고로 다가온다. 공장을 가동하며 매일 쏟아내는 방대한 제조 노하우와 공정 데이터를 로봇 학습용 자산으로 구조화하지 못한다면, 로봇 하드웨어를 제대로 활용하기 어렵다.
그렇다면 이 막대한 현장 데이터를 빨아들이며 직접 로봇을 찍어내는 양산 무대에서는 지금 어떤 일이 벌어지고 있을까. 다음 4부에서는 프리몬트 공장에서 옵티머스 생산 라인을 가동하기 시작한 테슬라와 세계 최대 최고의 로봇기업으로 급성장 중인 유니트리, 그리고 피규어 AI가 벌이는 치열한 휴머노이드 양산 전쟁의 내막을 추적한다.
[기획시리즈] 글로벌 피지컬 AI 패권 경쟁
1부. 오픈AI, 로보틱스 전담팀 해체… 피지컬 AI 경쟁축 바뀌나
2부. 엔비디아 Isaac·GR00T, 로봇 AI 플랫폼 패권 경쟁
3부. 휴머노이드 데이터 전쟁… 실제 산업 현장이 AI를 키운다
4부. 테슬라·피규어AI·유니트리, 휴머노이드 양산 경쟁
5부. 로봇용 NPU와 엣지 AI… 온디바이스 컴퓨팅의 부상
6부. 제조·물류·국방, 피지컬 AI 상용화의 경제성
7부. 미·중 피지컬 AI 패권 경쟁과 글로벌 공급망 재편


David is the Editor of The Science Monitor. Drawing on extensive experience as the Republic of Korea (ROK) Navy officer, he provide in-depth analysis at the intersection of science, technology, global security, geopolitics, and maritime strategy.
Contact: navy@scimonitors.com | LinkedIn