OpenAI, 텍스트로 이미지 만드는 AI 모듈 공개
텍스트로 설명하면 이미지가 자동으로 생성되는 AI가 공개됐다.
미국 샌프란시스코 인공 지능 개발 회사 OpenAI의 연구팀이 GPT-3 자기 회귀 언어 모델에 새로운 모듈을 추가했다. ‘DALL · E‘라고 불리는이 모듈은 여러 특성을 가진 텍스트를 발췌해 분석한 후 설명된 내용을 바탕으로 그림을 생성한다.
OpenAI의 팀은 새로운 모듈을 설명하는 웹 페이지에서 이를 “간단한 디코더 전용 변환기”라고 설명하고 아키텍처에 대한 자세한 정보를 제공 할 계획이며 자체적으로 학습할 때 사용할 수있는 방법에 주목한다.
GPT-3은 신경망이 텍스트 처리 및 생성을 얼마나 활용할 수 있는지 보여주기 위해 개발했다. 사용자가 선택한 텍스트를 분석하고 해당 입력을 기반으로 새 텍스트를 생성한다. 예를 들어 사용자가 “아이를 불 속에 구하는 개에 대한 이야기를 해줘”라고 입력하면 GPT-3는 인간과 같은 방식으로 그러한 이야기를 만들 수 있다. 두 번째로 동일한 입력이 발생하면 다른 버전의 스토리가 생성된다.
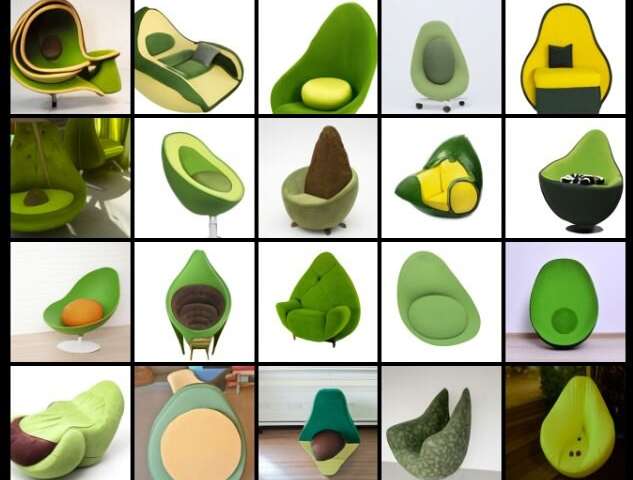
연구원들은 이 기능을 그래픽으로 확장했다. 사용자가 문장을 입력하면 DALL · E가 그래픽 및 기타 이미지를 사용해 설명된 내용을 생성한다. 예를 들어, 사용자가 “고양이 발톱과 새 꼬리가있는 개”를 입력하면 시스템은 이러한 특징을 가진 개가 아닌 만화 같은 이미지를 생성한다. 원본 텍스트에 대해 약간 다른 해석을 사용하여 생성된 전체 라인을 생성한다.
이 시스템은 인터넷 페이지로 구성된 정보 코퍼스를 사용해 이미지를 생성할 수 있다. 텍스트의 각 부분은 어떻게 생겼는지 알아보기 위해 조사된다. 앞선 예에서는 수천 개의 개 사진을 검색하고 분석한다. 그런 다음 고양이와 그들의 발톱이 어떻게 생겼는지, 그리고 새와 꼬리를 연구했다. 그런 다음 결과를 여러 그래픽 이미지로 결합해 사용자에게 다양한 결과를 제공한다.


David is the Editor of The Science Monitor. Drawing on extensive experience as the Republic of Korea (ROK) Navy officer, he provide in-depth analysis at the intersection of science, technology, global security, geopolitics, and maritime strategy.
Contact: navy@scimonitors.com | LinkedIn