기계학습으로 정확하고 효율적인 양자 오류 완화
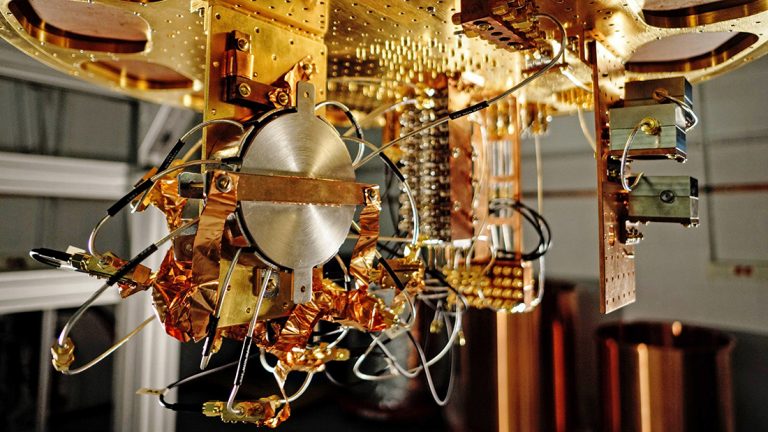
양자 컴퓨터는 최적화 및 데이터 처리와 같은 특정 작업에서 고전 컴퓨터보다 우수한 성능을 발휘할 잠재력을 가지고 있다. 하지만 양자 시스템은 큐비트(양자 정보의 기본 단위)를 제어하는 데 어려움이 있어 오류에 더 취약하다. 오류를 줄이기 위한 양자 오류 완화(uantum error mitigation, QEM) 기술이 개발됐지만 비용과 시간 측면에서 실용적이지 않았다.
최근 IBM Quantum 연구원들은 기계 학습(machine learning, ML)을 비용 효율적인 대안으로 활용할 수 있음을 보였다. 그들의 연구는 Nature Machine Intelligence에 발표됐다. 연구는 ML 기술이 전통적인 QEM 방법과 유사한 정확도를 달성하면서도 더 낮은 비용으로 오류 완화를 가능하게 한다는 것을 입증했다.
이 연구를 이끈 하오란 리아오(Haoran Liao)는 기계 학습이 양자 컴퓨터에서 발생하는 오류를 어떻게 학습할 수 있는지 연구했다. 양자 컴퓨터가 고전 컴퓨터로는 풀 수 없는 문제를 해결하는데 유용하다는 점에서, 고전적인 ML 모델이 양자 계산에서 발생하는 오류를 어떻게 이해할 수 있을지 의문이 있었다. 이에 연구진은 ML이 양자 오류 완화를 더 효율적으로 만들어 더 큰 규모의 실험을 가능하게 할 수 있는지 탐구했다.
연구팀은 최대 100개의 큐비트를 사용하는 최첨단 양자 컴퓨터에서 여러 작업을 수행하며 ML 기술을 테스트했다. 이들은 고전 컴퓨터로는 해결할 수 없는 문제들에 집중했다. 처음에는 복잡한 그래프 신경망(GNN) 모델을 사용해 양자 회로의 구조를 표현했지만, 더 간단한 랜덤 포레스트(random forest) 모델이 다양한 회로와 노이즈 모델에서 더 좋은 성과를 보였다.

리아오는 “우리는 양자 회로의 노이즈를 어떻게 변형할 수 있는지 실험하면서 ML이 어떻게 노이즈를 학습하는지에 대해 더 잘 이해할 수 있었다”고 설명했다. 이들은 단순히 성능을 측정하는 데 그치지 않고, ML 모델이 양자 컴퓨터에서 발생하는 복잡한 노이즈와 이상적인 출력을 어떻게 연결 지을 수 있는지에 대해 연구했다.
연구 결과, 랜덤 포레스트 모델을 사용한 ML은 전통적인 방법에 비해 계산 자원을 절감하면서도 높은 정확도를 유지할 수 있음을 보여주었다. 연구는 양자 오류 완화의 계산 오버헤드를 50% 이상 줄일 수 있다는 것을 입증했다. 이는 실험 시간을 대폭 줄이고, 양자 컴퓨터로 해결할 수 있는 실험의 범위를 확장하는 데 중요한 역할을 한다.
이번 연구는 이론적, 실용적으로 중요한 의미를 갖는다. ML이 양자 오류를 이해하고 QEM 방법을 더욱 접근 가능하게 만드는 데 도움이 될 수 있음을 제시했다. 리아오 연구팀은 ML이 양자 오류 완화에 있어 기존의 물리학 기반 방법을 대체하는 것이 아니라, 오히려 함께 활용되어 더 효과적인 결과를 가져올 수 있음을 강조했다.
이번 연구는 양자 컴퓨터에서 ML을 활용한 가능성을 열고 향후 더 효율적이고 확장 가능한 양자 실험을 가능하게 할 수 다.