中 독자 GPU 두 얼굴: ‘플래그십 추격’ 톈가이 300 vs ‘연산력 괴리’ LX 7G100
미국 첨단 반도체 수출 통제 장기화 속 중국 반도체 업계가 선보인 최신 GPU 제품군에 대한 업계 실측 검증과 기술 분석 결과가 엇갈리고 있다.
엔터프라이즈 AI 데이터센터 시장을 겨냥한 일루바타 코어X(Iluvatar CoreX·天数智芯)의 ‘톈가이(天垓) 300’은 엔비디아 H200 급 처리량을 내세우며 랙 단위 물량 공세를 본격화했다. 소비자용 PC 시장에 등판한 리수안 테크(Lisuan Tech·砺算科技)의 ‘LX 7G100’은 연산 수치 대비 처참한 실게임 효율을 보이며 독자 아키텍처의 한계를 노출했다.
톈가이 300: “H200 넘었다” 144-GPU 초고밀도 랙 베팅
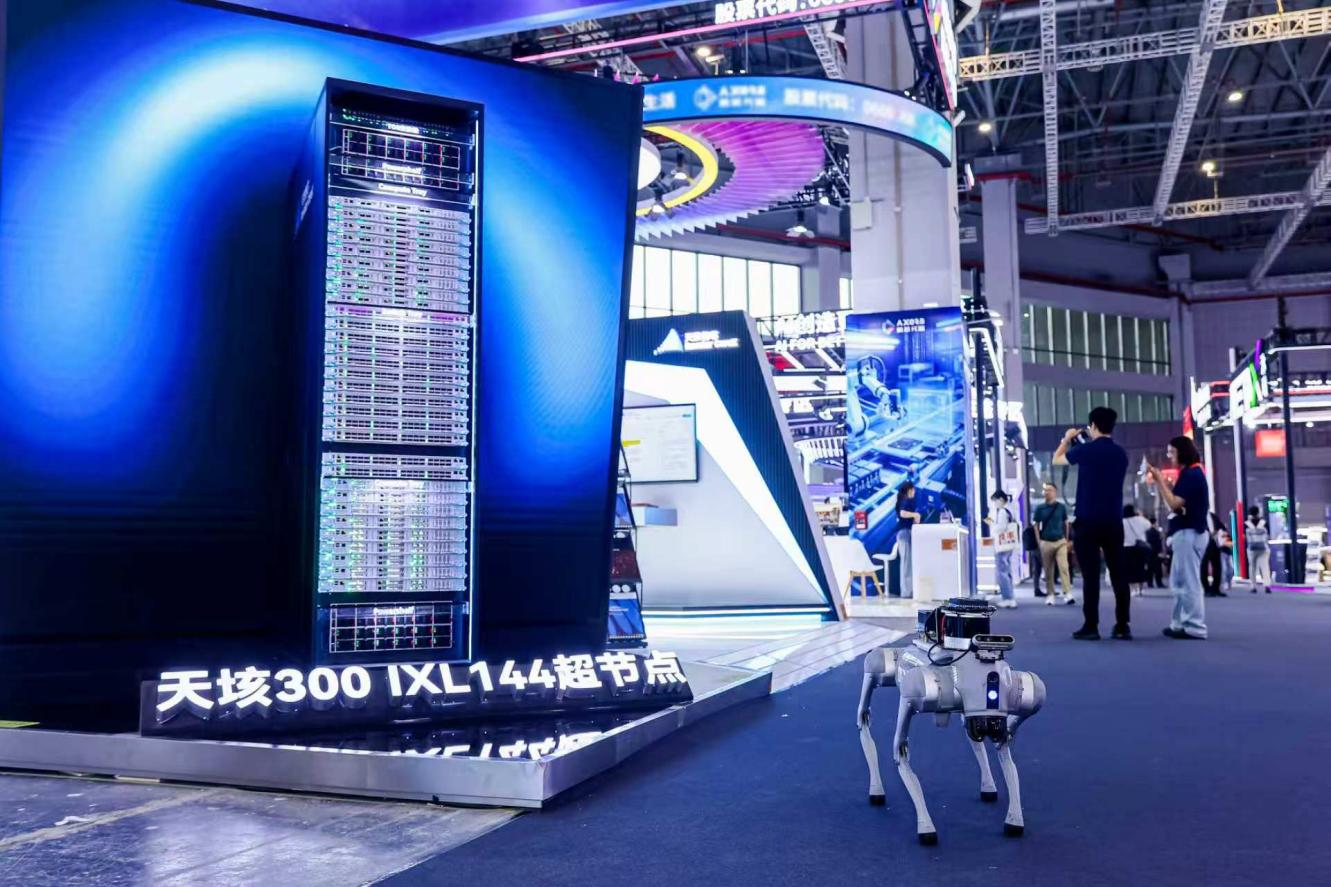
일루바타 코어X가 공개 및 실측 시연한 최신 범용 GPGPU ‘톈가이 300’은 글로벌 표준인 엔비디아 호퍼(Hopper) 기반 H200을 정조준했다.
제조사는 제3자(상하이 INESA 등) 테스트를 인용해 카드당 종합 정규화 처리량(Normalized per-card aggregate throughput)이 엔비디아 H200의 1.05배에 달한다고 발표했다. 관련 매체 MRKT30는”이 수치는 단일 칩의 절대 연산 지연시간이 아닌 다중 카드 환경에서 평균을 낸 종합 처리량 지표”라며, 구체적인 벤치마크 워크로드와 정밀도(FP8/FP16) 조건이 완전히 공개되지 않았음을 지적했다.
단일 칩의 물리적 미세공정 한계를 극복하기 위해 일루바타는 단일 캐비닛(랙)에 144개의 GPU, 18개의 CPU, 약 10.1TB 메모리를 집적한 ‘IXL144 슈퍼노드’ 시스템을 앞세웠다. 랙 내부 초고속 인터커넥트를 통해 랙 간 통신 병목을 줄이고, 밀리언 유효 토큰당 비용을 글로벌 주류 시스템 대비 40% 절감하겠다는 전략이다.
독자적인 CANN 생태계를 강제하는 화웨이 어센드(Ascend)와 달리, 톈가이 300은 GPGPU 본연의 범용성과 CUDA 시맨틱 네이티브 호환을 채택했다. 여기에 어텐션과 피드포워드 네트워크 연산을 이종 칩셋으로 분리 스케줄링하는 ‘AFD(Attention-FFN Disaggregation)’ 아키텍처를 도입해 추론 지연시간을 최대 60% 단축했다고 주장한다.
| 제품 | 포지션 | 표기 연산력 / 처리량 | 실측 성능 및 체급 (외신 종합) | 전력 효율 / 특징 |
| Iluvatar CoreX 톈가이 300 | 데이터센터 / AI 학습·추론 | 단일 카드 처리량 H200의 1.05배 주장 | 복합 MoE 처리량 우위 주장, 단일 칩 실측 검증 진행 중 | 단일 랙 144-GPU 초고밀도(IXL144), CUDA 네이티브 호환 |
| NVIDIA H200 | 글로벌 플래그십 AI 가속기 | 141GB HBM3e, 4.8TB/s 대역폭 | 글로벌 데이터센터 최고 표준 (검증 완료) | 독점적인 CUDA / TensorRT-LLM 풀스택 생태계 |
| Lisuan Tech LX 7G100 | 데스크톱 게이밍 (중국 내수) | FP32 24.6 TFLOPS | GTX 1060 ~ RX 580 수준 (RTX 5060의 1/3) | 아이들 59W / 풀로드 199W, 하드웨어 RT 부재, WHQL 획득 |
| NVIDIA RTX 4060 | 글로벌 레퍼런스 메인스트림 | FP32 15.1 TFLOPS | LX 7G100 대비 약 2.5~3배 높은 실게임 프레임 | 115W 저전력, DLSS 3 및 전용 3세대 RT 코어 탑재 |
리수안 LX 7G100: 24.6 TFLOPS 허상… 실게임은 ‘GTX 1060급’
게이밍 그래픽카드 시장에 독자 TrueGPU 아키텍처로 출사표를 던진 리수안 테크의 ‘LX 7G100’은 서구 주요 하드웨어 전문 매체의 벤치마크에서 혹평을 받았다.
스펙 시트상 단정밀도(FP32) 연산 성능은 약 24.6 TFLOPS로 엔비디아의 메인스트림급인 지포스 RTX 4060(약 15 TFLOPS)을 수치상 크게 앞선다. 그러나 독일 PC Games Hardware(PCGH) 실측 결과, 1080p 게이밍 성능은 과거 파스칼 세대의 지포스 GTX 1060 6GB 대비 23% 앞서는 수준, 혹은 라데온 RX 580 수준에 그쳤다. 현역 엔트리 라인업(RTX 4060·RTX 5060)과 비교하면 3분의 1(약 27~33%) 수준의 처참한 프레임 효율이다.
59W에 달하는 과도한 아이들(대기) 전력 소모와 하드웨어 레이 트레이싱(RT) 전용 유닛 부재로 최신 DX12 타이틀 구동 시 극심한 병목이 확인됐다. 미성숙한 셰이더 컴파일러와 그래픽 파이프라인의 낮은 하드웨어 활용률이 원인으로 지목된다.
과거 무어스레드(MTT S80)가 보여준 잦은 블루스크린과 구동 불가 현상과 달리, 마이크로소프트 WHQL 인증을 통과하며 최소한의 ‘실행 안정성’을 확보했다는 점만이 외신들이 꼽은 진전이었다.
업계는 중국 GPU 업계가 제재 속에서도 ‘구동 가능한 하드웨어’를 내놓는 데는 성공했으나, 게이밍 분야(LX 7G100)에서는 그래픽 파이프라인과 소프트웨어의 벽을 넘지 못했다고 평가한다. 반면 엔터프라이즈 AI 분야(톈가이 300)에서는 미세공정 격차를 랙 단위 패키징(슈퍼노드)과 CUDA 호환 소프트웨어 우회로로 만회하려는 현실적인 생존 전략을 취하고 있다는 분석이 지배적이다.