




과학자들은 새로운 양자 기반 학습에 대한 첫 번째 원리 증명 실험을 보고했다.
국제 연구팀은 나노 광자 프로세서를 사용하여 고전 및 양자 통신을 모두 사용하는 강화 학습 기술을 수행, 작업 속도를 크게 높이는 방법을 보여주었다. 이 접근법의 가능한 응용 분야가 로봇 공학에서 의료에 이르기까지 다양하다.
강화 학습(reinforcement learning)에는 의사 결정을 내리는 일종의 에이전트와 환경 간의 반복적 상호 작용이 포함된다. 후자의 일련의 자극 또는 “지각”에 응답하여 전자는 각 경우에 특정 행동 과정을 취한다. 상담원이 올바른 행동을 선택할 때마다 어떤 식으로든 보상을 받은 다음 그에 따라 향후 대응을 수정한다. 시간이 지남에 따라 각 경우에 올바른 대응을 선택한다는 아이디어를 사용한다.
반복되는 좋은 성과에 대한 보상에 기반한 기계 학습 알고리즘 일종인 강화 학습은 훈련 시간이 많이 걸리는 문제가 있었다.
그러나 양자 역학은 각 턴에서 두 가지 특정 행동 과정을 결정하는 대신 학습자는 두 가지 가능한 행동을 중첩해 반응한다. 이는 보다 세밀한 응답 스펙트럼을 도입, 더 빠른 학습을 가능하게 한다.
오스트리아 비엔나 대학교(University of Vienna)의 발레리아 사지오(Valeria Saggio)는 도로의 교차점에 서서 어느 길로 갈지 결정하는 사람의 비유를 사용합니다. 좌회전이나 우회전을 선택하는 대신, 그 사람은 두 가지 옵션의 특정 조합을 사용하여 동시에 좌우로 회전합니다.
양자 강화 학습(quantum reinforcement learning)의 개념은 오스트리아 인스브루크대학 한스 브리겔(Hans Briegel)과 동료들에 의해 2016년에 제시됐다. 같은 그룹의 이전 관련 작업은 오류 디코딩 및 양자 실험 설계에 도움이 되는 양자 정보 처리에 도움이 됐다. 그러나 이러한 모든 이전 연구에는 환경과 고전적으로 상호 작용하는 에이전트가 포함돼 학습 시간이 전반적으로 단축되지 않았다.
통합 나노 광자 플랫폼
최근 작업에서 브리겔은 비엔나 대학, 오스트리아, 네덜란드 및 미국의 다른 동료들과 함께 양자 통신을 사용해 이러한 아이디어를 구현했다. 실제로 그들이 시연한 시스템은 에이전트가 고전적 확률 분포에 따라 또는 모든 보상 및 비보상 행동의 중첩을 생성하여 행동할 수 있는 하이브리드 시스템이다.
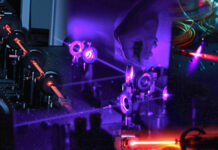
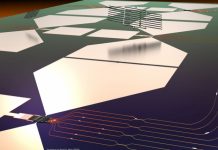
이 시스템은 수많은 조정 가능한 빔 스플리터를 형성하기 위해 제작된 일련의 도파관을 포함하는 완전히 프로그래밍 가능한 나노 광자 프로세서(nanophotonic platform)를 포함한다. 프로세서에 들어가는 단일 광자(통신 파장에서)는 고전적 또는 양자 역학적으로 작용하며 후자의 경우 장치는 에이전트에 해당하는 첫 번째 및 마지막 영역과 환경에 해당하는 중간 영역의 세 영역으로 이상적으로 분할된다.
프로세서를 떠날 때 각 광자는 옳고 그른 결과에 해당하는 두 개의 초전도 나노 와이어 검출기 중 하나에서 특정 확률로 감지된다. 그런 다음 시스템은 해당 출력을 등록하고 기존 컴퓨터를 사용해 학습 알고리즘을 업데이트한다. 다음 단일 광자는 이 수정된 절차에 따라 조작된다.
필립 왈더(Philip Walther)가 이끄는 협업팀이 입증한 특정 프로토콜은 각 출력에 대한 여러 지각 및 작업으로 구성된 “에포크(epochs)”에서 데이터를 처리하는 것과 관련이 있다. 양자 시대의 보상 결과를 직접 감지할 수 없었기 때문에 연구원들은 양자 시대와 고전 시대를 번갈아 가며 학습 알고리즘을 업데이트하는 데 사용했다.
만 번의 시뮬레이션과 165번의 실험을 수행한 연구원들은 양자 전략과 순수하게 고전적인 전략의 효과를 비교했다. 그들은 전자가 처음에는 훨씬 더 빨리 학습, 학습 시간을 63%까지 단축했지만 나중에 실제로는 시간이 지남에 따라 악화 된다는 것을 발견했다(특정 시점 이후에 효율성이 떨어지는 글로버(Grover) 유사 알고리즘). 반대로 고전적인 전략은 처음에는 느리지만 꾸준한 개선을 보였다.
실험 설정을 통해 에이전트는 전자의 효과가 떨어지기 시작하면 양자에서 클래식 버전으로 전환하여 전략을 최적화 할 수 있다. 혼합 전략이 순전히 고전적인 다양성에 비해 얼마나 빠른지에 대해 연구원들은 원하는 성공 임계값에 따라 달라진다고 지적한다.
연구팀은 특히 “대형 검색 공간”에서 빈번한 검색 등 컴퓨터 네트워크 라우팅 사례에서 수십 개의 광자, 도파관 및 탐지기를 사용하면 시스템이 약 만 개의 가능성에서 최적의 경로를 설정할 수 있다고 추정한다.
연구원들은 초전도 검출기, 단일 광자 소스 및 광자 회로에서 인공 원자의 발전 덕분에 이러한 다중 광자 응용 분야를 향한 상당한 진전이 이루어질 수 있다고 생각한다.
*Saggio, V., Asenbeck, B.E., Hamann, A. et al. Experimental quantum speed-up in reinforcement learning agents. Nature 591, 229–233 (2021). https://doi.org/10.1038/s41586-021-03242-7


David is the Editor of The Science Monitor. Drawing on extensive experience as the former Public Affairs officer for the Republic of Korea (ROK) Navy, he provide in-depth analysis at the intersection of science, technology, global security, geopolitics, and maritime strategy.
Contact: navy@scimonitors.com | LinkedIn